一份 CLAUDE.md 管不住 agent
agent 干了件我不想让它干的事,我以前的第一反应就是往 CLAUDE.md 里加一句话。import 了不该 import 的模块,就加一句「领域层不许 import adapter」;跳过测试直接说做完了,就加一句「宣布做完之前必须先跑测试」。加完感觉问题解决了,还挺踏实的。
只能说,这么干基本没用,而且它错在两个方向上。一是散文根本绑不住 agent;二是你往里加的每一句散文,都会让 agent 把别的事干得更差。两条都挺反直觉的,我一条一条讲。这篇也是给 agent 盖一个能维护的仓库这个系列的第三篇。
指令文件是 context,不是强制
先讲第一条。指令文件其实就是一段 context。这不是我自己的解读,Anthropic 的文档写得挺清楚,CLAUDE.md 是「会被加载进模型 context 的记忆」,runtime 不会去强制执行它。AGENTS.md 一样,Cursor 的 rules 也一样。它们就是一段文本,模型会读,也会受它影响,仅此而已。文件叫 agent 别干的事,整个系统里没有哪一环会真的动手把它拦下来。
这个道理点头容易,真往心里去挺难,因为指令文件看着很权威。它通篇都是祈使句,满眼「必须」「永远不」。但你冷静想一下,「领域层永远不许 import adapter」这句话躺在一个 md 文件里,谁来执行?没人。它一直都「有效」,直到有一次任务做到一半,context 已经堆得很满,重构已经走了三个 tool call,agent 找到一个非这么干不可的理由,然后它就这么干了。模型是个概率系统,你的规则只是它同时要顾着的一堆软偏好里的一个。它手上要抛接的东西越多,软的那些掉得越早。
所以如果一个仓库的 README 里写着「core 不许 import adapter」,可 core 真 import 了 adapter 的时候,CI 里没有任何东西会挂,那这条就算不上规则,只是写下来的一个愿望。agent 早晚会让你尝到后果。它干了不让干的事,散文没拦住,你 review 的时候才发现,或者更糟,你压根没发现。
修法其实很直接,承重的规则全部改成能执行的检查。一件事如果真的必须成立,就得有个东西在它被违反的时候挂掉,光靠一句求 agent 配合的话不行。具体大概是这几类:
- 边界规则,比如「领域层保持纯净、不 import 框架、不碰 IO」,改成 lint 规则(
no-restricted-imports、no-restricted-globals),或者架构测试(ArchUnit、dependency-cruiser,或者干脆写个二十行的脚本,grep 被禁的 pattern,命中就非零退出)。 - 「单文件不超过 300 行」,改成 CI 里的巨文件检查,配一个 allowlist,allowlist 里每一条都要写 owner 和过期时间。
- 「别手改生成的代码」,改成 generated-clean 检查,重新生成一遍,跑
git diff --quiet,有 diff 就挂。 - 「宣布做完之前先跑验证」,改成一条命令,CI 里跑的也是一模一样的这条。做没做完看 exit code,不看 agent 自己觉得怎么样。
这些检查有个共同点,它们都不信任模型,而它们管用,恰恰就是因为不信。agent 有多自信,散文写得多有说服力,检查一概不管,它只看这一次违没违反。违反了就挂,坏东西进不了 main,就这么简单。
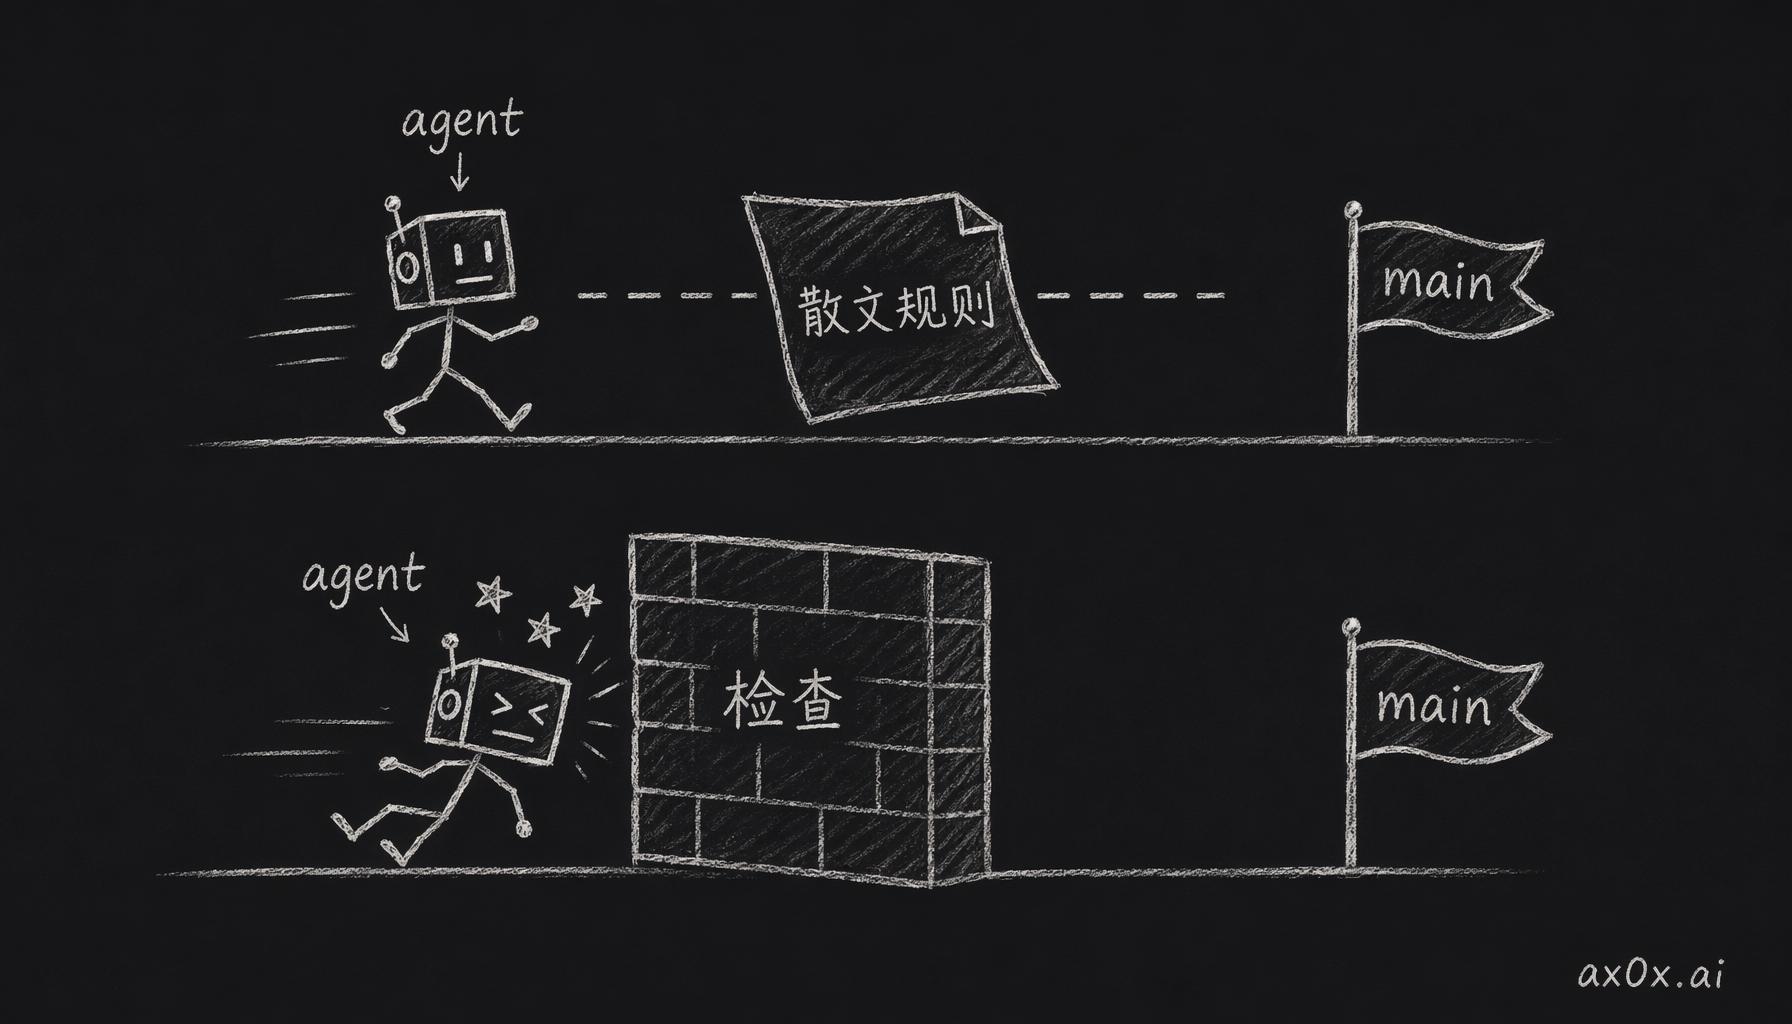 散文规则拦不住 agent,检查才是墙
这一点我是在自己的配置上吃过亏才明白的。我的全局配置里本来有一句话,明明白白告诉 agent,别再让我 review 你的产出,长文我不审,那是你自己的活。这句话就是没用。agent 还是回回在结尾来一句「要不要我带你过一遍方案」,因为「对用户客气」在训练里是个很强的先验,配置文件里的一句话只是个很弱的信号,弱的干不过强的。最后解决问题的是一个 stop hook,它检查这一回合的输出,一发现讨好式的 review 请求就直接拦下来,不让这个回合结束。那句散文在配置里挂了好几周,一点用没有;hook 上线第一天就管用了,真的就是第一天。同一条规则,效果差这么多,就差在 agent 和结果之间有没有卡着一段确定性的代码。
所以我现在的想法很简单,散文只管把意图讲清楚,拍板的是 hook、lint、CI 这类确定性的检查。一条规则要是真重要,就得有个模型之外的东西来兜底,不然它只是被写下来了而已。
指令堆多了,agent 反而变笨
第二个方向更隐蔽,就算接受了第一条,还是很容易栽在这。你把该强制的都做成了检查,散文多半还留着,想着反正都写了,留着也没坏处。其实有坏处。指令文件每个 session 都会被加载进 context,而 context 不是白给的。它相当于一份固定的注意力预算,你给模型的所有东西,都得从这份预算里分。你往常驻文件里多加一句话,它就多跟手上真要干的活抢一份注意力,也跟文件里别的每一条规则抢。
各家 lab 都记录过这个现象,叫 context pollution,文件过了一定大小,指令越多,反而越不可靠。一个五千行的指令文件,塞满了历史决策、边角 case、「还有上次那个记得别再犯」,agent 不会因此更小心,只会更容易在一堆这次用不上的规则里,把这次改动最要紧的那三条弄丢。规则攒多了还会互相打架,模型只能自己猜哪条优先,可你当初写规则,就是不想让它猜。
所以 agent 一干错事就加条规则,这么干其实两头亏。新加的那条还是散文,照样绑不住它;它还多占了一块 context,把文件里别的规则也冲淡了。context 花出去了,该拦的还是没拦住。
解法是分层。常驻的指令文件是一条热路径,原则就一条,热路径上只放每次都用得上的东西,别的按离 agent 注意力的远近,一层层往外放。
- 全局规则:一小段通用工作习惯,验证纪律、commit 偏好这类。仓库架构不放这。
- 仓库的
AGENTS.md:架构地图、常用命令、边界、做完的定义。它是一张路由图,不是知识倾倒场。 - 模块本地的文件:局部的例外跟它管的代码放一起,agent 真进了那个子目录才会加载。
- skill:长流程、多步的 runbook,用到的时候再拉进来,不常驻。这就是 progressive disclosure(按需披露),常驻的文本能一直这么短,靠的就是这个泄压阀。
- 任务 prompt:这一次的目标、范围、验收标准。
写顶层文件的时候该问的,不是「关于这个仓库有哪些事是真的」,而是「agent 每次干活都需要哪些东西」。后面这个问题圈出来的东西少得多,真的少得多。剩下的全往外挪,挪进有作用域的文件,挪进 skill,最好是干脆变成一个检查,不占 context,反正每次都会跑。
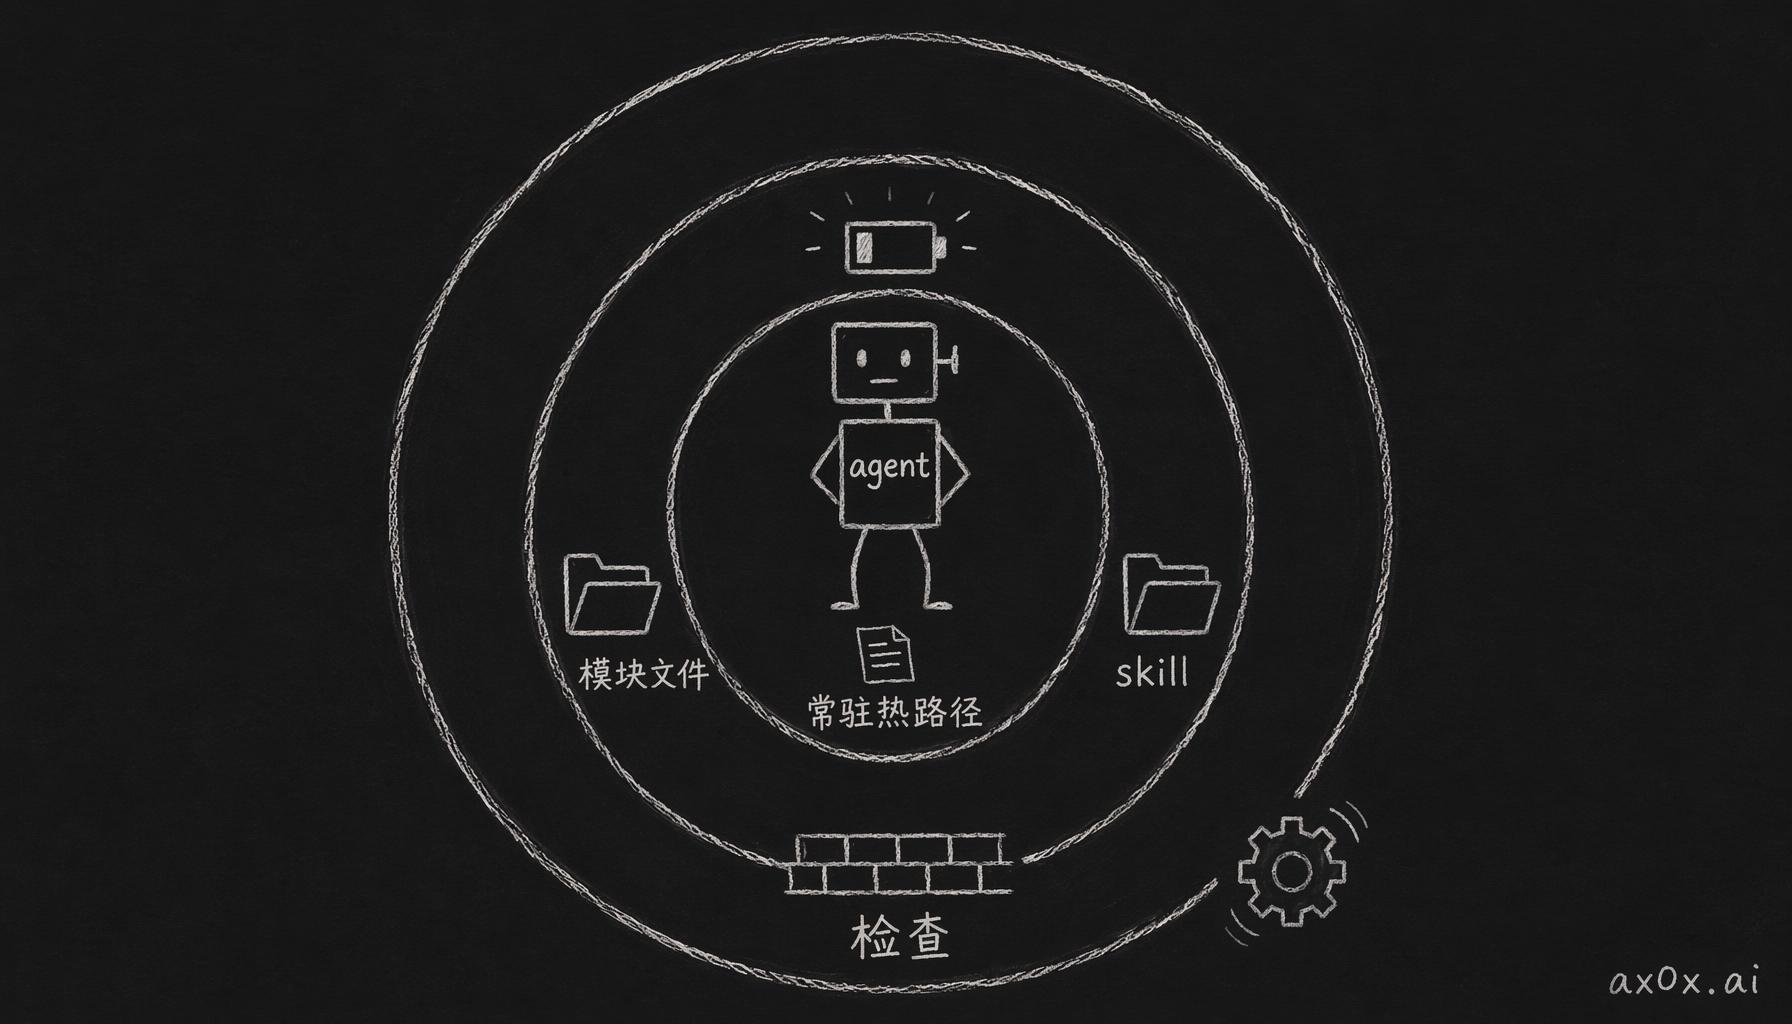 规则按离 agent 注意力的距离分层:热路径最小,检查在 context 之外
所以正确的动作是什么
这两条合起来,该怎么做就跟直觉正好反过来了。agent 干错了事,该做的几乎从来不是加一段话,而是二选一。如果这条规则是承重的,就写一个检查,hook、lint 规则、架构测试都行。写完以后散文反而可以删短,因为那些字一直没干成的活,现在检查在干。如果这条规则只是个偏好,就把它放到作用域最窄、真会用到它的那个地方,全局文件保持精瘦。
这两个动作其实往一个方向走,常驻的 md 越改越短,强制力慢慢都挪到 hook、lint、CI 这些检查里去。agent 这个工人的特点很明确,快,死板,照字面执行,换个 session 就什么都不记得。对这种工人,建议说得再客气,也不如一条它绕不过去的检查。散文的活就是把意图讲清楚,把东西在哪讲清楚;强制这个活它本来就干不了,也不用硬让它干。
所以上一篇和下一篇都在反复讲那条验证命令,因为所有强制力最后都收在它这里,agent 必须过,没得商量。指令文件可能写错,可能过期,也可能被无视,验证命令照跑不误。你的 AGENTS.md 只要告诉 agent 有这么一条命令、怎么跑,剩下的交给命令自己。
这是 agent 可维护仓库系列四篇里的第三篇。上一篇:agent 看不见没写下来的约定。下一篇:agent 自己说做完了,不算数。相关:光有聪明的大脑还不够——这里说的 hook 和验证命令,就是那篇讲的 harness 对准你自己仓库的样子。