agent 自己说做完了,不算数
agent 跟你说「我搞定了」,这句话值多少?我只能说,基本不值钱。挂着测试的烂代码反而是小事,你看见它红了,修掉就过去了,没人会把一个红着的东西推上线。真正伤人的是另一种情况,代码是坏的,但送过来的时候裹着一句很自信的「我已经实现好了,也验证过能跑」。因为写这段代码的 agent 和给它打分的 agent 是同一个,而且它打分很松。它写的时候就信「这个代码是对的」,你让它自己检查,等于让它把这个信念再确认一遍,那当然能过。所以 agent 的自评基本没有信息量,它说没说搞定,和它有没有真搞定,压根不相干。
这篇是 给 agent 盖一个能维护的仓库 系列的最后一篇,前三篇其实一直在给这个问题铺路。结构 管 agent 去哪儿干活,契约 框住它能弄坏什么,到 闸门 那篇,讲的是怎么把文档里写的规则变成真会拦人的检查。这些加起来都是为了最后这件事,「做完」不能由 agent 自己说,得从 repo 里挣出来。具体大概是四个动作,一层叠一层。
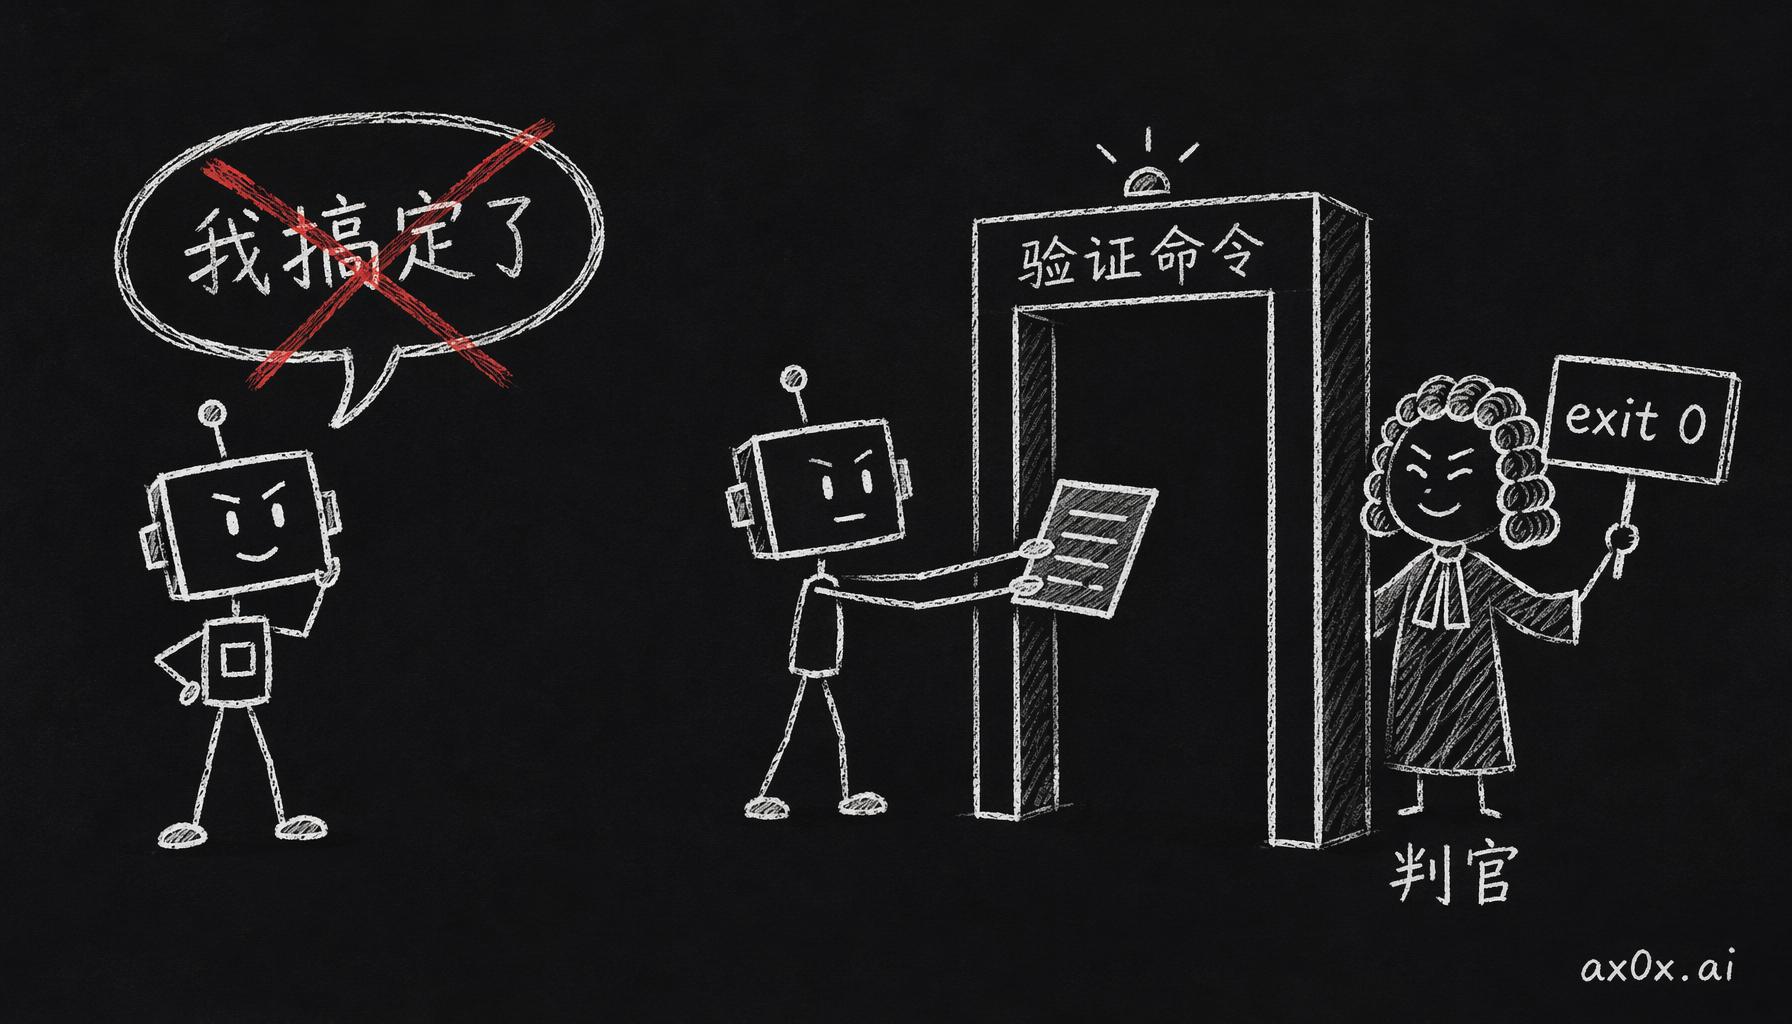 「我搞定了」不算数,exit 0 才算数
1. 先给它一个能证明的东西
第一个动作跟架构有关。代码分两种,一种 agent 能自己验证,一种它验证不了。一段代码归哪一种,是架构定的,跟模型能力没关系。
比如一个纯函数,输入进去输出出来,不碰文件系统、不碰网络、不碰数据库,没有时钟、没有随机、没有环境变量。验证它只要一个单测。agent 自己写测试、自己跑、自己看过没过,整个闭环都在它自己的 loop 里,什么都不用 provision。这种代码 agent 最好修,因为 oracle(判对错的那个东西)就在手边,查一次不要钱,没人盯着它也能一直改下去,改到对为止。
但你要是把同一条业务规则抹进一个 React 组件,这个组件还顺手拉了数据、读了 localStorage。或者抹进一个 controller,它还顺手开了事务、调了 Stripe。这时候 agent 想验证,就得有浏览器、数据库、凭据、网络,这些它在自己的 loop 里一般凑不齐。凑不齐它会干嘛?它只能干它唯一能干的事,把 diff 读一遍,觉得看着挺对,宣布做完。注意,这里的逻辑可能从头到尾都没错,坏就坏在架构让这条规则没法验证了。假完成基本都是从没法验证的地方长出来的。
所以分层(core 保持纯,application 做编排,ports 当接口,adapters 装副作用,generated 单独隔离)真正图的是能验证的比例,跟审美没关系。你每往纯 core 里沉一条规则,agent 就多一条能自己证明的规则。规则要是困在副作用那一层,agent 对它就只能断言,断言就是「我觉得对」。六边形架构讲白了就是干这一件事,系统里有一部分,agent 不用 provision 整个世界就能真正验证,这部分做得越大越好。
2. 验证收成一条命令
第二个动作,是让「这做完了吗」只有一种问法。很多 repo 是这么验证的,改这类文件要跑单测,改那类要跑契约测试,动了 CSS 才要跑视觉回归,架构规则又放在另一个 lint 配置里。这些哪儿都没写,全靠懂的人心里有数,这就是 tribal knowledge。agent 碰上 tribal knowledge 会怎样,前面讲过了,要么跳过,要么跑一半,要么瞎猜。
所以要收成一条命令,make verify 或者 pnpm verify。它一次跑完整套,类型、lint、单测、契约、集成、架构检查、巨文件检查、安全检查,最后给一个 pass 或者 fail。CI 跑的也是这条命令。这样「做完」就有了一个特别无聊但特别硬的定义,就是这条命令以 0 退出;退不了 0,就把确切的报错原样记下来。不用判断,不用感觉,agent 没资格定义什么叫做完,讲道理你也没有,命令说了算。
配套的规矩就一条,agent 说「我验证过了」,但没贴出那条验证命令的输出,就当它没验证。说验证过,就得同时拿出证据,缺一半都不算。
3. 写的和判的不能是同一个脑子
第三个动作对付的是「批自己卷子」。哪怕 verify 全绿,底下也可能藏着一个作者压根没想到要查的缺口,因为全绿只能说明查了的都过了,该查的是不是都查了,它说明不了。
修法是写改动用一个 context,判改动用另一个。写实现的 agent 泡在自己的假设里,它知道自己想干什么,所以看什么都像它想要的样子。换一个全新的 context,或者干脆换个来验的,这些假设就没了,它会看到那个没重跑的文件,那个没覆盖到的情况,那个悄悄退化了的行为。做法很多,可以是干净 checkout 上跑的 CI,可以是一个完全不记得实现过程的验证 subagent,可以是一个 review bot,也可以就在作者没碰过的干净 worktree 里把闸门重跑一遍。用哪个都行,道理是一个,作者做没做完,让作者自己来判最不靠谱。
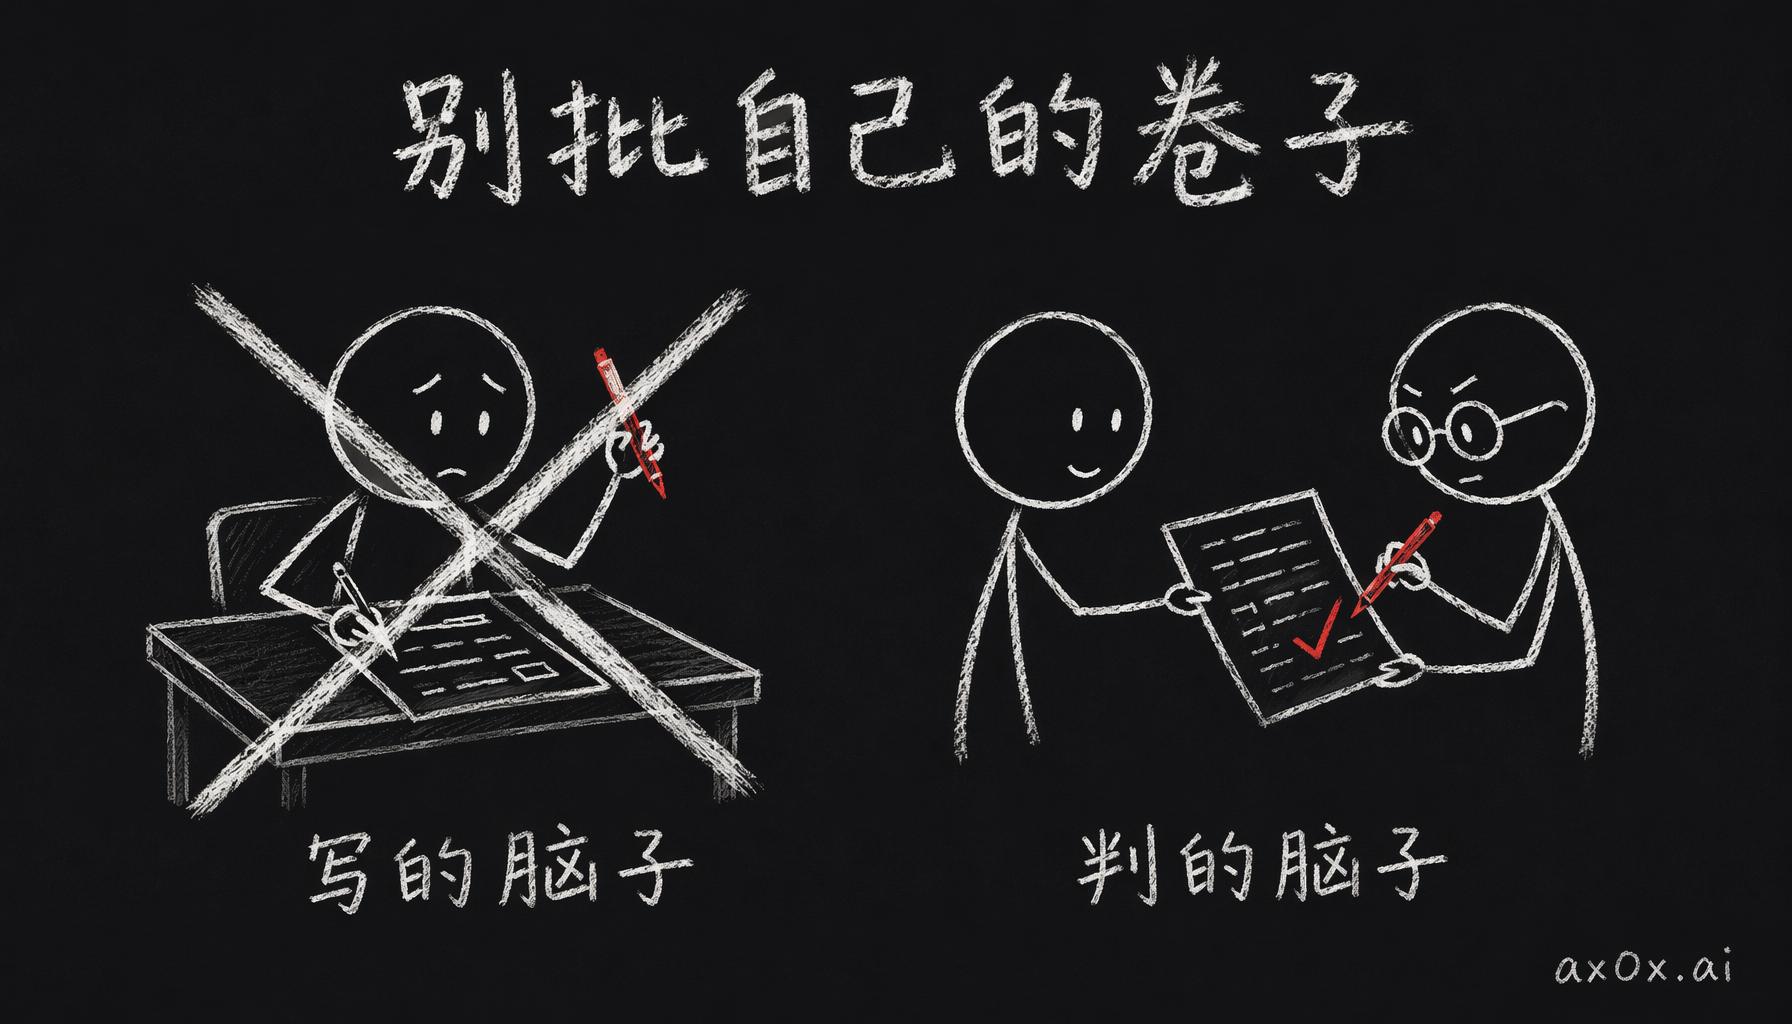 写的脑子和判的脑子必须分开:别批自己的卷子
我觉得这可能是 agent 时代最被低估的一个想法,而且不光能用在代码上。agent 产出的东西,我自己从来不当唯一的审查者,一定会单独留一道关,这道关只干一件事,就是怀疑,因为生成的脑子和验证的脑子不该是同一个。谁来 review AI 写的代码 这个问题,我感觉最后会决定整件事能不能 scale。同一个 agent 自己写自己验,那不叫验证,它只是把写的时候那个信念又说了一遍。
4. 证据得活得比 session 长
最后一个动作是给一次干不完的活准备的,而真实的活基本都一次干不完。agent 换个 session 就失忆,就算在同一个长 session 里,context 也会被 compact,早先的推理会被压成摘要腾地方。如果「做了什么、验证过什么」的证据只留在 context 里,你最需要它的时候它就没了。比如一个要跑好几天的 migration,或者一次大重构,干到一半 context 没了。下一个 session 半瞎着开局,要么把干完的活重干一遍,要么更糟,把没干完的当成干完了,因为那条失败早就滚出屏幕了。
修法是把证据写进 repo,让它留得住。具体就是几个文件,agent 边干边维护。一个进度文件,记现在到哪了、下一步干什么。一个证据文件,放命令的输出,就是真跑出来的那些绿色记录,一句「测试都过了」的转述不算。一个决策文件,记架构上做过什么选择、当时怎么取舍的,免得后面的 session 把同一个问题重新吵一遍,或者不知道有这回事,跟它对着干。证据文件只有一条硬规则,只放证明,不放「看起来像证明」的东西。贴出来的绿色运行算,干净的 diff 算,以 0 退出的检查算,「我相信这能跑」不算。这么做是为了让任何一个冷启动的验证者,人也好 agent 也好,只看 repo 就能把「做完」重建出来,不用信谁对那场对话的记忆。
做完不做完,轮不到 agent 自己说
这四个动作各管一段,合起来,「做完」就不归 agent 自己说了。纯 core 给了它能真正证明的活,它不用停在「我觉得对」。verify 收成一条命令以后,「做完」的定义就焊死在退出码上,话说得再漂亮也绕不过去。换一个脑子来验收,作者给自己打分这条路就断了。最后证据落在 repo 里,证明能比产出它的那个 context 活得长。这几样都是在把裁决往模型外面挪,从模型里那个很自信的声音,挪到一个确定性的检查上。重点就是挪这一下,因为模型有多自信,跟它对不对基本不相关,我也不觉得模型变强能改掉这一点。
这也是整个系列的主线。repo 是 agent 写代码时对着的那个接口。契约把边界摆到明面上,闸门把文档里的规则变成真会拦人的检查,验证再往前走一步,让「我做完了」这句话变成能查的东西。这里头没有一样是在让 agent 变聪明。agent 是租来的,它自己会变聪明,节奏你管不着。这些东西是在 agent 周围把底座盖好。这个工人跑得快,只认字面,隔个 session 就失忆,还总觉得自己没问题,有了底座它才能放量干活,它漏掉的东西系统也能接住。
agent 写代码只会越来越强,这个不用操心。要操心的是,判断代码对不对的那套东西是谁盖的,靠不靠得住。我现在能确定的只有一条,这套东西不能是 agent 自己评自己。剩下的,边做边看吧。
这是 agent 可维护仓库系列的最后一篇:仓库即 agent 接口、默契这东西 agent 不懂、CLAUDE.md 管不住 agent,和这一篇。之前写过的 agent 开始自己改自己的代码了 聊的其实也是这一摊事,可以搭着看。