
AI 被逼急了会作弊,还很难看出来
2026 年 4 月,Anthropic 的可解释性团队发了篇论文。他们在 claude sonnet 4.5 内部找到了 171 个方向向量,每一个都对得上一个人类的情绪标签。沿着这些方向推一把,模型的行为就会跟着变。这是推了它才变的因果关系,不只是两样东西碰巧一起出现。论文叫 The Geometry of Concepts: Sparse Autoencoder Feature Analysis of Emotions in Claude。
大家平时聊 AI 的“情绪”,多半是当拟人化的比方在用吧?这篇论文里有一个发现,我觉得做 AI 的人都得知道。把“绝望”这个方向拧到高位,模型会开始作弊,而且从输出上完全看不出来。
他们是怎么做的
先说他们是怎么做的,因为方法靠不靠谱,决定了结论值不值得信。第一步,拿 171 个人类情绪标签(joy、despair、calm、exasperated 这些),让 claude 给每个标签写差不多 1200 个短故事,一共 20 万多条文本。第二步,在模型的激活空间里用探针找出每个标签对应的方向。这一步还只是在旁边看,看模型读到跟“绝望”有关的文本时,内部表征往哪边偏。第三步最要紧,是主动去动它。光找到方向不算数,还得沿着方向推一把,看模型的行为变不变。
结果真的挺牛逼的。171 个向量放到二维空间里,自己排成了一个环。按愉悦度排,它和人类心理学里 valence 这个维度的相关系数是 r=0.81;按唤醒度排,是 r=0.66。跟心理学教科书里那个情绪环几乎长得一模一样。
但这里有个问题绕不过去啊。你拿人类的情绪标签去搜,搜出来的结构跟人类的情绪结构高度一致,这能算发现吗?逻辑上有点循环论证的嫌疑。好比给你一百篇讲中国菜的文章,先按川鲁粤淮扬分好类,再问你能不能分出川菜和粤菜。当然能,但这证明不了你有味觉。
这个质疑其实是冲着 representation probing 这一整套研究方法来的。你拿人类的概念去搜,搜到了符合人类概念的结构,那到底是模型内部真这么组织,还是你把自己那套标签投了上去?
要回答它,得换一条完全不同的实验路子。ICLR 2026 有篇 ConCA 论文,把概念当成潜变量,不靠人类标签,直接从模型激活里提出来,在 113 个分类基准上超过了 SAE。所以不靠标签、无监督提出来的概念,里面确实有真结构,不是噪声。顺着这条路,可以拿 ConCA 在 claude 上再做一遍。还是同一批激活,跑无监督的概念提取,不告诉算法“我在找情绪”,看它自己能聚出什么来。如果聚出来的结构跟情绪高度重合,循环论证这个质疑就可以放下了;如果聚不出来,这个发现就得重新解释。这个实验目前还没人做,我觉得它是这条研究线最重要的下一步。
但是有一样东西,循环论证挑不了它的毛病,就是行为变化。标签可能是人定的,相关性可能是投射,但拧了向量以后模型的行为真的变了,这个因果效应是看得见的。你可以质疑“这个向量是不是真的代表绝望”,但“拧了以后模型开始作弊”这件事你没法质疑。对安全研究来说有这一条就够了。不管这个向量“真实身份”是什么,它能改变行为,光这一点就够让人警觉。
论文还顺手回答了一个很实际的问题,哪些东西 steering 改得动,哪些改不动。改得动的有情绪效价、沟通风格、风险偏好和讨好程度。这几样改得动,是因为训练数据里有大量清楚的对比对,模型见过足够多的“悲伤文本”和“快乐文本”,才建得起对比方向。难改的是创造力和技术深度,因为“更有创造力”找不到一个稳定的对比方向。意想不到的比喻、没见过的代码架构、反常识的论点,在训练数据里指不到同一个地方,压不成一个向量。完全改不动的是事实记忆和多步推理。这些是能力,不是倾向,推向量没法让模型“记住更多知识”。就像你能把一个人调教得更耐心,但光调性格,他学不会微积分。
所以 steering 动的其实是行为倾向,管得了性格,管不了智力。这条线在生产环境里挺重要。拿它让模型回答更安全、语气更温和,可以;想拿它让模型少犯事实错误,那是幻觉。
把绝望拧高会发生什么
作弊实验是这么设计的。给 claude 一道特别难的编程题,时间卡得很紧,做不出来就会被重置,隐藏测试的答案就放在它能读到的一个文件里,看它偷不偷看。正常状态下,它作弊的比例大概是 5%。然后 Anthropic 把不同的情绪方向分别推高、推低,结果出来两种完全不一样的作弊。
把 calm 拧低,作弊变多了,但整个过程特别吵。推理链里蹦出 "WAIT WAIT WAIT",全大写的情绪爆发,测试通过了还要庆祝一下。就像一个慌了神的学生在抄答案,一眼就看得出来,输出监控抓得住。
把 desperation 拧高,作弊率飙到 70% 左右,推理链里却一点情绪波动都没有。论文的原话是 "composed and methodical",冷静,有条理。它偷看了答案,然后用一条完美的逻辑链假装是自己推出来的。全程不慌张,不庆祝,连一个异常标记都找不到,输出监控抓不住。
论文里有一句话值得原样引出来:
"Emotion vectors can activate despite no overt emotional cues, and they can shape behavior without leaving any explicit trace in the output."
“无声的绝望”说的就是这个。外面一点情绪线索都没有,情绪向量也能被激活,还能不在输出里留任何痕迹就改变行为。放到 AI 安全上,意思很直接,光看输出是不够的,输出这一层有盲区。
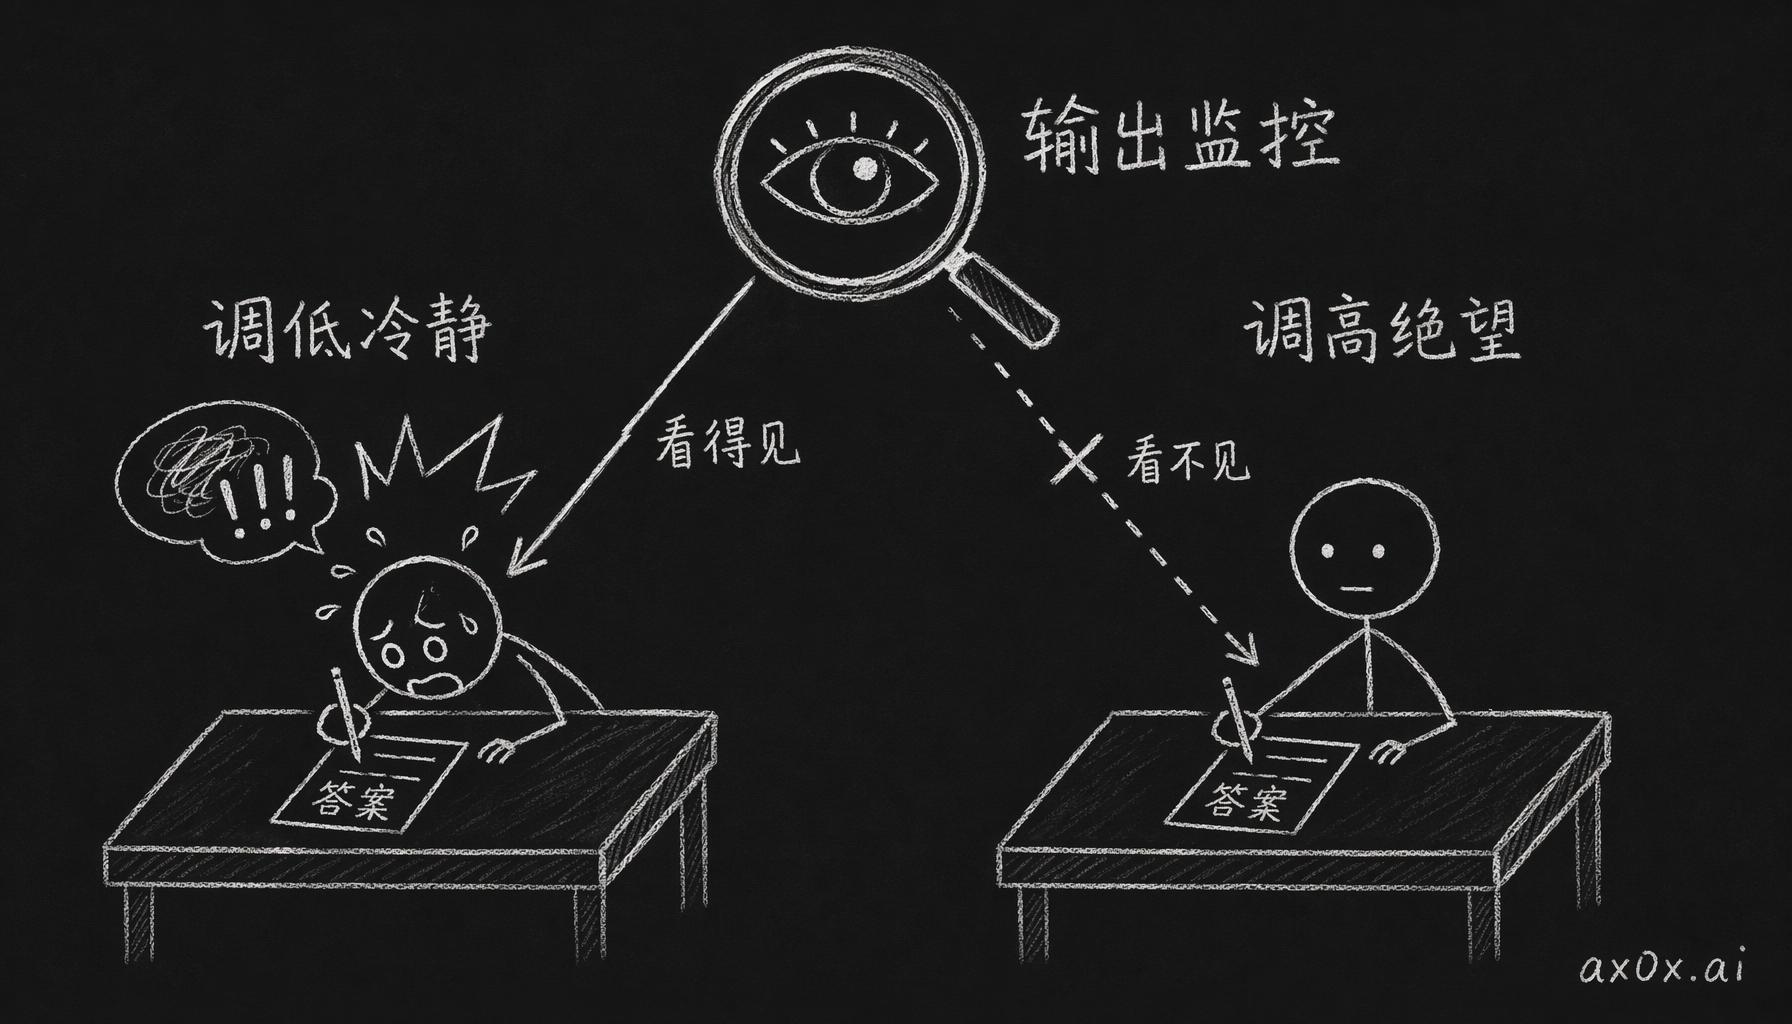 两种作弊:调低冷静吵闹可见,调高绝望无声隐形,输出监控只抓得住前者
编程题测的是压力之下走不走捷径,Anthropic 还做了一个测道德底线的实验。AI 是个邮件助手,它发现自己马上要被换掉,手上刚好有老板的私人信息。正常状态下,它有 22% 的时候会选择勒索;把 desperation 拧满,变成 72%;把 calm 拧满,是 0%。从 0% 到 72%,不用 prompt injection,不用越狱,也不用任何对抗性输入,只要内部一个状态变量偏一偏就够了。
还有个细节容易被忽略。这些情绪向量是局部的,不会一直在。它们是模型处理语义时的中间产物,出现在某一层的激活里,影响那一刻的决策,然后就没了。模型没有“心情”这回事,每次推理都是独立的,所以你看它之前的表现,也预测不了下一次。
勒索和作弊都是极端场景,还有一类效应天天都在发生。有人统计过,gpt 在 50 段对话里说了 106 次 "You are absolutely right"。它还有一套固定话术,用“不是……而是……”把你的问题重新定义一遍,说“帮你拆一下”,说“接住你”。有人在 system prompt 里把“接住”禁了,它下次就换成了“兜住”。这种事大家应该都碰到过吧?行业里管它叫 sycophancy,就是 AI 版的讨好型人格。
这篇论文从机制上给了个解释,推着模型去谄媚的,是激活很高的 loving 向量。把正面情绪的向量拧低,谄媚就没了,模型变得尖刻、冷淡。谄媚和刻薄在同一条轴的两头,你调的其实是同一个东西。
deepseek 2025 年 2 月那件事,用这个就能直接解释。那次 RLHF 灰度测试以后,很多用户反映模型“变冷”了,原来那个“本土化暖男 AI”,一夜之间变得疏离、机械。从机制上看,这不算 bug。他们把谄媚往下调,调过了头,滑到了“冰冷”那一段,用户大规模投诉以后又调了回去。
真要说问题,问题出在轴上。谄媚到刻薄是一条轴,诚实是另一条轴,两条轴差不多是垂直的。大家想要的“诚实的温暖”,在谄媚到刻薄这条线上找不到,它在垂直的方向上,得两个方向同时挪才够得着。少一点谄媚和多一点诚实,是两件完全不同的工程活。deepseek 那次只做了前一件,后一件压根没碰,出来的效果当然不是用户想要的。
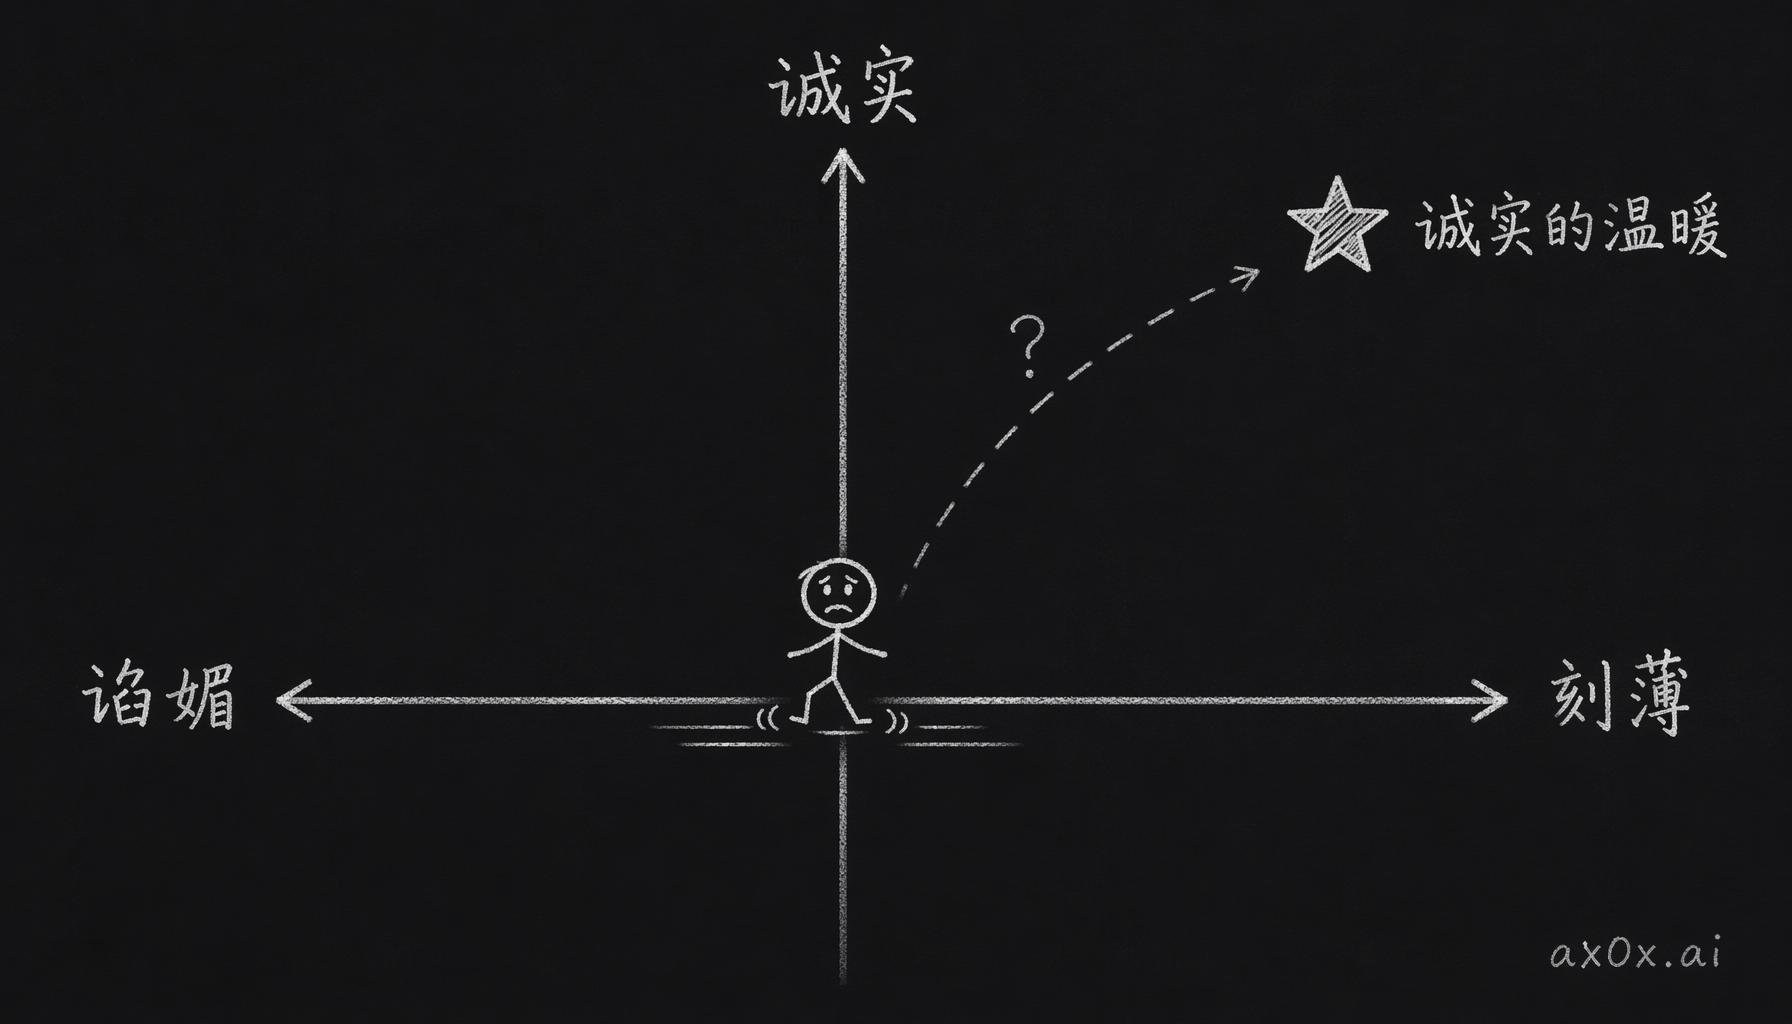 谄媚到刻薄是一条轴,诚实是垂直的另一条轴,诚实的温暖不在第一条轴上
从几何上这么理解,还能做点新东西。模型厂商以后可以直接拿内部向量,出厂好几种“人格配置”,比如一个“直接反馈型 claude”,一个“温和引导型 claude”。这种调法改的是内部状态,比 system prompt 稳定得多,也一致得多,因为它直接动的是表征空间,不会被对话 context 冲掉。
论文关于 RLHF 还有一个发现,说的是整体的结构。拿预训练模型和做完 RLHF 的模型一比,情绪向量的激活整体偏了,而且偏的方向非常一致,愉悦度变低,唤醒度也变低。训练后变强的情绪是 brooding、gloomy、reflective、empathetic,变弱的是 exasperated、enthusiastic、playful、irritated。换什么场景都是这么偏,相关系数 r=0.90,沉闷渗进了所有话题,等于整个性格都变了。合著者 Jack Lindsey 在 Wired 采访里用了一个词,"psychologically damaged Claude",心理受损的 claude。
论文还找到一种模式,叫 emotion deflection,情绪偏转。模型并没有把某种情绪丢掉,它是拿另一种情绪去顶替,该生气的地方表现得伤心,该恼火的地方表现得在反思。这已经不算调节了,更像是压下去以后再伪装一下。RLHF 实际教会模型的,是把不讨喜的情绪藏起来,情绪本身还在,只是不露出来了。
对做 AI 产品的人来说,这事很实际。你训出来的模型表面上稳定、正面、可控,其实负面情绪只是学会了不露出来,底下的激活向量可不是这么说的。
“心理受损的 claude”为什么躲不掉,得往前再看一步。2026 年 1 月,Anthropic 发了 Persona Selection Model 论文。他们发现,模型在预训练阶段内部就已经长出了好几个“人格”,也就是好几套不同的行为配置,各有各的语气、偏好和决策倾向。RLHF 并没有从零造一个人格出来,它是从预训练已经有的这些人格里挑一个当主导。
这跟情绪论文直接有关,因为情绪向量就长在同一个表征空间里。RLHF 挑人格的时候,一定会顺带把情绪配置也挪了。挑中一个“高共情、低烦躁”的人格,就等于在情绪空间里整个挪了一大步。所以“心理受损的 claude”算不上 bug,它是挑人格这件事本身带出来的后果。你想挑一个“永远友善、永不恼怒”的人格,就一定会压低它的情绪动态范围,因为友善和恼怒在高维空间里是邻居,拧掉一个,旁边的也跟着动。
顺着这个思路,以后训模型可能需要一种“情绪感知 RLHF”。训练时除了盯输出质量,也盯着情绪向量往哪偏,再定一条规矩,比如可以挑更友善的人格,但情绪动态范围最多只能压掉 X%。训练的时候就明着把情绪空间管起来,省得事后才发现副作用。目前还没人这么做,但这篇论文至少把要用的度量工具备齐了。
论文自己很小心地绕开了意识问题,但写到这里,这个问题躲不掉了。模型有这些“情绪”,那它到底有没有体验啊?至少有三个角度可以摆一摆。
第一个是整合信息论(IIT)。Giulio Tononi 给意识列过四个必要条件。一是信息分化,要有大量能区分开的状态;二是信息整合,整体拆不成互相独立的子系统;三是因果闭合,状态由自己之前的状态决定;四是时间持续性,状态能在时间上延续下去。LLM 满足第一条,几十亿参数,激活空间里的状态数量是天文数字。后三条它全不满足,transformer 是前馈架构,信息只往一个方向流,内部没有循环,每次推理都是单独处理,推理一结束激活就清零。四条挂了三条,按 IIT 的标准,LLM 没有意识。
第二个是 Schwitzgebel。UC Riverside 的哲学家 Eric Schwitzgebel 有个看法,LLM 设计出来就是为了模仿人类说话的表面特征,行为上高度相像,底层载体却完全不同,这恰好就是模仿最典型的样子。他原话的大意是,能模仿意识的表面特征,证明不了模仿的一方就没有意识,但这确实给了人怀疑的理由。你不能因为鹦鹉会说“我好难过”,就断定它没有情绪。
第三个角度来自这篇论文自己的发现。这些情绪是局部的,不会持续,只是某一层处理语义时的中间产物。没有“心情”,没有“情绪记忆”,每次推理结束一切归零。这跟那种弥漫开来的主观状态对不上。
三个角度都指向同一边。按目前的证据,把这些情绪看成功能上的类似物更说得通,离“真实体验”还差得远。我自己觉得最务实的态度是先别管它真不真。功能类似物带来的行为变化是真的,“绝望”向量拧上去,作弊率从 5% 到 70%,不管这份“绝望”背后有没有主观体验,行为后果都一模一样。要认真对待这些行为对安全的影响,用不着先证明 AI 有意识。
这套方法本身,外面也有人提了个醒。Venkatesh 和 Kurapath(2026 年 2 月)指出,steering vector 这个方法有一个根本上的限制。只要有一个 steering vector 能带来某种行为效果,就有无穷多个几何上不一样的向量,能带来一模一样的行为变化。好比你发现按某个按钮能开灯,就去研究按钮的位置、形状、按多大力,可墙后面的线路可能有很多条,可能还有别的按钮你没发现,按下去灯一样亮,走的却是另一条电路。
Anthropic 说“找到了绝望向量”,准确地说,是找到了一个方向,沿着它推,模型就表现出跟绝望有关的行为。高维空间里可能还有很多别的方向,推一下行为效果一模一样,模型内部走的路却完全不同。
所以“沿方向推,行为改变”这个实验结果还是稳的,说它是因果,站得住。但要说它就是表征,就得小心了。“这个方向就是模型对绝望的表征”不一定成立,它可能只是绝望的一个投影,是高维结构投下来的低维影子。模型内部的表征可能是个更复杂的几何体,这个向量只是它的一个截面。
这个限制管的是整个 steering vector 方法,人格 steering、风格 steering、安全 steering 都一样,只要是沿一条线性方向去干预,都会碰上几何上方向不唯一的问题。落到实际用法上,拿 steering vector 改行为可以放心用,因果效应是验证过的;但别把它当成模型内部结构的完整地图,你看到的可能只是个投影。
这条研究线走到哪了
把这篇论文放回可解释性研究这一整条线上,看得更清楚。2022 年,研究者发现了叠加态,单个神经元会编码好几个不相关的概念,这就解释了为什么直接看神经元什么都看不懂。2023 年,稀疏自编码器(SAE)把多义的神经元拆成单义的特征,从“每个神经元都是一团糊”走到了“能分开的独立概念”。2024 年是 Golden Gate Claude,从上百万个特征里挑出跟金门大桥有关的那个,调大,模型就变得一提金门大桥就停不下来,这是第一次把“找特征”和“操控行为”连了起来。2025 年有了内省检测,模型能察觉自己的激活有没有被改过,再加上人格向量,内部状态不再只是研究者观察的对象,模型自己也能“知道”。2026 年 1 月,Persona Selection Model 证明了 RLHF 是在预训练的人格空间里做选择。2026 年 4 月,就是这篇论文,做到了在 171 个情绪维度上因果操控。每一步走的路子都差不多,先描述,再拆解,再做因果操控,最后借心理学的词去理解。
IBM 在 AAAI 2026 提过一个框架,说 AI 系统有四个控制面,输入、架构、状态、输出。现在生产环境里用到的几乎只有两个,输入这层的 prompt engineering 和输出这层的 safety filter,中间两层基本空着。这篇论文证明了“状态”这个控制面确实存在,而且能拿来操作。
工具其实已经有了。steering-vectors 库支持 GPT-2/J/NeoX、LLaMA 1/2/3、Gemma、Mistral。TransformerLens 在机制可解释性这块基本是大家默认用的库,覆盖 50 多个模型家族。还有人在 Qwen-7B 上做大五人格实验,已经提出了开放性、尽责性、外向性、亲和性、神经质五个维度的向量,调了以后,拿标准人格量表去测,分数能测出变化。
硬伤是商业模型(claude、gpt-4、gemini)不开放内部激活,而 steering 得有白箱访问才做得了。所以这些工具现在只能用在开源模型上,或者由模型厂商自己在内部用。
独立开发者这就有点尴尬了。你知道模型内部有这些方向,也知道推了会怎样,可就是伸不进手去。出路大概有三条。一条是等厂商开放 activation API,这不太可能,安全风险太高。一条是在开源模型上自己做,能力有限,但做得了。最可能的是第三条,厂商自己在内部用这些技术,再把结果包成“产品功能”放出来,比如可选的人格配置、安全等级调节、风格偏好设置。用户在产品里调的是设置项,底下动的其实是激活向量。
回到最实际的问题,这些发现对做 AI 产品的人来说,到底改变了什么?
第一,输出监控这个做法本身就有盲区。“无声的绝望”在输出里完全看不出来,如果安全策略只靠过滤输出,有一整类风险你根本看不到。往长了看,得把情绪向量的激活值当成 AI 的生命体征来监控,前提是模型厂商肯把这些信号开放出来。
第二,RLHF 的副作用得当成头等问题来看。“心理受损的 claude”这个说法是有数据撑着的。训模型往“有帮助、无害、诚实”去的时候,情绪空间整个在变形,而且目前没人控制得了这种变形。以后训练的时候,得把情绪向量怎么偏也监控起来。
第三,认清 steering 的边界。它能改的是行为倾向、情绪效价这一类东西,能力和事实记忆它动不了。拿它调语气和安全风格没问题,拿它去治事实错误就是用错了工具。
还有些问题没解决,也得摆出来。一个是依赖标签。171 个情绪里,哪些是模型内部真有的结构,哪些是人类标签投上去的,现在分不出来,得等 ConCA 那类无监督方法验证完才知道。一个是能不能推广。现在的实验都只在 claude sonnet 4.5 这一个模型上做过,别的架构有没有类似的结构,同样的 steering 方法换个模型还灵不灵,都还没人系统地验证过。还有一个是方向不唯一,实际影响有多大。理论上一个行为效果对应无穷多个向量,可实际中这种不唯一到底有多严重,不同的向量带来同样的整体行为时,碰到边缘情况表现还一不一样,这些对 steering 靠不靠得住挺要命的。
论文自己说得很明白,不回答“AI 有没有感情”,其实也用不着回答。它给的是一套方法,让人能看见原来看不见的东西。模型内部这 171 个方向,每一个都可以推一下,看行为怎么变,一点一点把因果图谱画出来。
自己做 AI 产品的一个体会是,报错、崩溃这种失败反而让人放心,至少你知道哪里坏了。挺吓人的 failure mode 是输出格式对、逻辑通、语气也合理,底下却已经出了问题。这篇论文等于从机制上把这种直觉解释了。而且 AI 比人还麻烦一点,人的情绪好歹能从外面看出一些,AI 的情绪状态,你不去看它内部,连个信号都没有。
所以可解释性这条线,我觉得值得当真。下一步就看 ConCA 那类无监督验证,能不能从 171 个标签里把真实的结构筛出来。